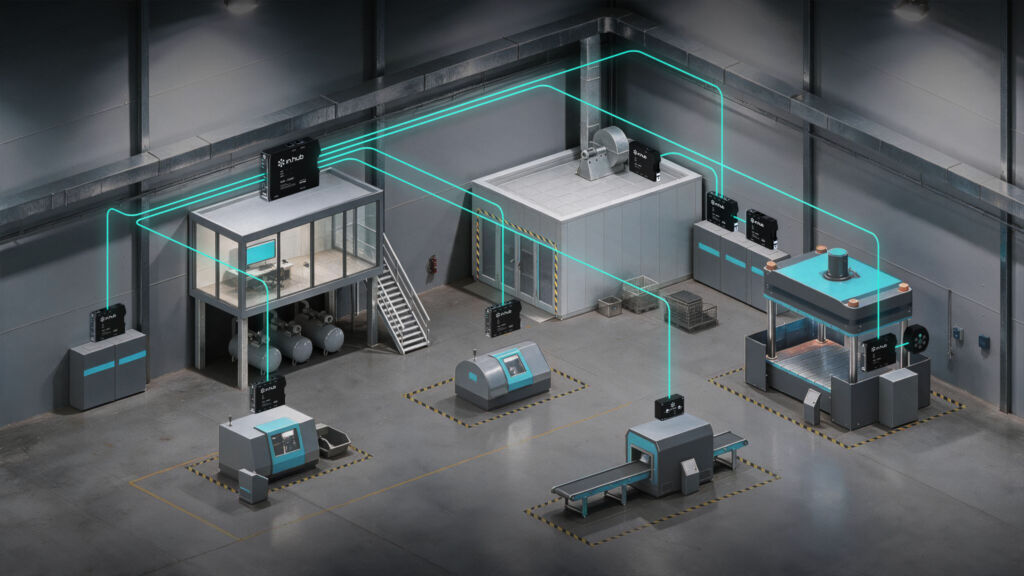
Viele Digitalisierungsprojekte in der Produktion beginnen im kleinen Rahmen. Zunächst wird eine einzelne Maschine angebunden, ausgewählte Datenpunkte werden erfasst und in einem Dashboard dargestellt. Eine solche Testinstallation zeigt schnell, ob sich Energieverbräuche, Maschinenzustände oder Stillstände besser auswerten lassen. Pilotprojekte erfüllen damit eine wichtige Aufgabe: Sie beweisen, dass ein Anwendungsfall technisch funktioniert. Ob sich dasselbe System wirtschaftlich und organisatorisch auf viele Maschinen übertragen lässt, ist damit noch nicht beantwortet. Was während der Erprobungsphase überschaubar bleibt, wird beim Roll-Out schnell komplex.
Aufgaben kommen hinzu
Mit wachsender Zahl der angebundenen Maschinen verändern sich die Anforderungen. Edge-Geräte müssen reproduzierbar in Betrieb genommen, Konfigurationen dokumentiert und Softwarestände gepflegt werden. Gleichzeitig braucht es klare Regeln für Benutzerrechte, Updates, Datensicherheit und den laufenden Betrieb. Ein System skaliert erst, wenn sich weitere Maschinen nach einem wiederholbaren Verfahren anbinden und betreiben lassen. Gerade in gewachsenen Produktionsumgebungen treffen unterschiedliche Maschinengenerationen, Steuerungen, Sensoren und Kommunikationsprotokolle aufeinander. Eine Anlage liefert Daten über OPC UA, eine andere über Modbus TCP, eine dritte nur über digitale Signale. Hinzu kommen unterschiedliche Variablennamen, Einheiten und Datenformate. In einer ersten Testinstallation lassen sich solche Unterschiede noch individuell lösen. Beim Roll-Out führen sie jedoch schnell zu Sonderlösungen, mehrfacher Pflege und Abhängigkeiten vom Wissen einzelner Personen. Skalierbarkeit verlangt daher keine identischen Maschinen, sondern einheitliche Regeln für Anbindung, Konfiguration und Verwaltung.
Standards statt Einzelsysteme
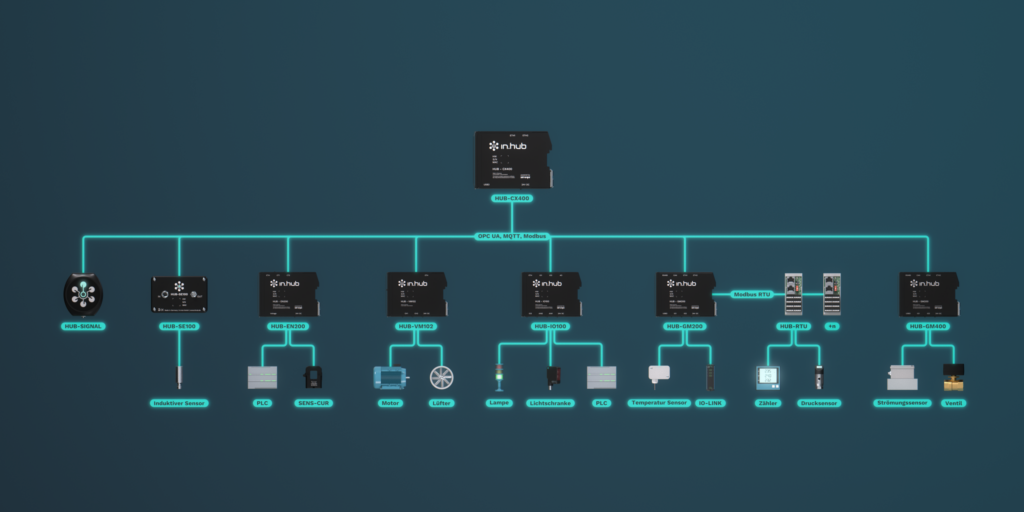
Für einen Maschinentyp kann ein Template festlegen, welche Datenquellen angebunden werden, wie Messwerte bezeichnet werden, welche Berechnungen lokal erfolgen und an welche Zielsysteme die Informationen gehen. Bei der Inbetriebnahme werden nur noch Parameter wie IP-Adresse, Maschinenkennzeichen oder Standort ergänzt. Das verkürzt die Installation und reduziert Abweichungen zwischen den Anlagen. Aus einer individuellen Konfiguration wird ein reproduzierbarer Prozess. Auch das Datenmodell muss diesem Prinzip folgen. Ein Maschinenzustand kann an der Quelle als Zahl, Text oder digitales Signal vorliegen. Für übergeordnete Anwendungen sollte er dennoch einheitlich als ‚produktiv‘, ‚bereit‘, ‚Stillstand‘ oder ‚Störung‘ interpretierbar sein. Dasselbe gilt für Stückzahlen, Energieverbräuche, Auftragsinformationen und Zeitstempel. Die Datenquelle bleibt maschinenspezifisch, die bereitgestellte Information folgt einer gemeinsamen Struktur. Erst dadurch lassen sich Kennzahlen über Maschinen, Linien oder Standorte hinweg vergleichen. Ohne einheitliches Datenmodell entstehen viele Dashboards, aber keine durchgängige Datengrundlage.
Edge wird Teil der Produktions-IT
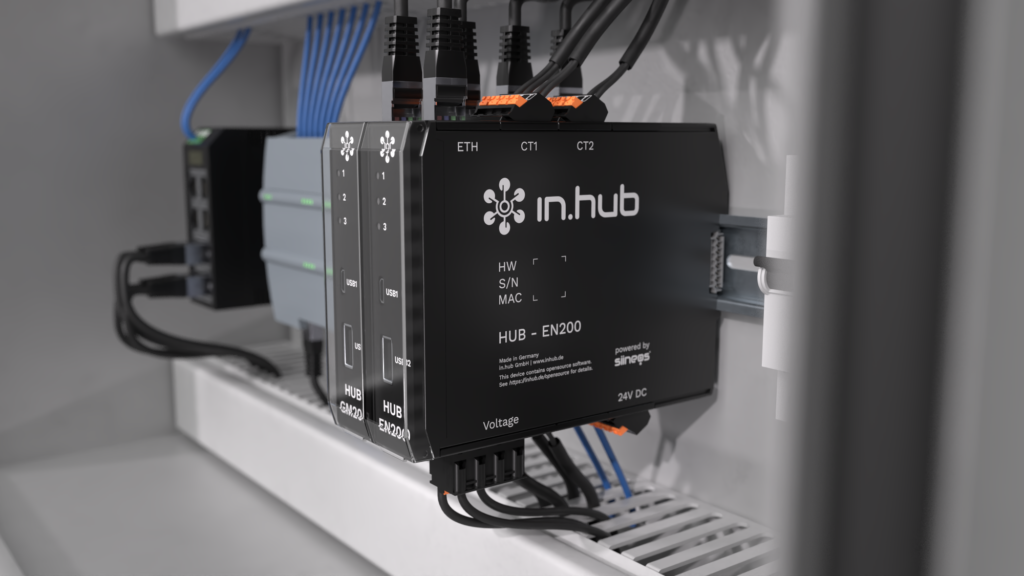
Während der ersten Erprobungsphase gilt ein Edge-Gerät häufig als lokales Hilfsmittel. Im Roll-Out wird es jedoch zum dauerhaft betriebenen Bestandteil der IT- und OT-Infrastruktur. Jedes Gerät benötigt daher eine eindeutige Identität, dokumentierte Software- und Konfigurationsstände, geregelte Zugriffsrechte sowie kontrollierte Kommunikationswege. Updates können bei einer größeren Edge-Flotte nicht dauerhaft manuell verteilt werden. Gleichzeitig dürfen sie nicht ungeprüft auf allen produktiven Systemen landen. Nötig sind Freigabeprozesse, Testgruppen und ein Rückweg auf den vorherigen Stand, der auch dann trägt, wenn ein Update fehlschlägt. Technisch lässt sich das absichern, indem ein Gerät zwei vollständige Systemabbilder vorhält. Das Update wird in den gerade inaktiven Bereich geschrieben, erst danach schaltet das Gerät um. Startet der neue Stand nicht sauber, fällt es automatisch auf den vorherigen zurück. Die Edge-Plattform